الذكاء الاصطناعي يتفوق على الأطباء في التشخيص داخل المختبر.. فلماذا لا يتحسن الأطباء عندما يستخدمونه؟
في عام 2026، نشرت مجلة Science، وهي من أكثر المجلات العلمية احترامًا في العالم، دراستين تقولان إن الذكاء الاصطناعي شخّص الحالات الطبية الصعبة أفضل من الأطباء. وجاءت العناوين صاخبة: «الذكاء الاصطناعي يتفوق على الأطباء في التشخيص». لكن مجموعة أخرى من الدراسات تشير إلى مشكلة أغرب: عندما يحصل الأطباء على الأداة نفسها، لا يتحسنون إلا قليلًا.
فمن على حق؟ وماذا يعني هذا لك كطالب في تخصص صحي؟
الأرقام التي تصدرت العناوين
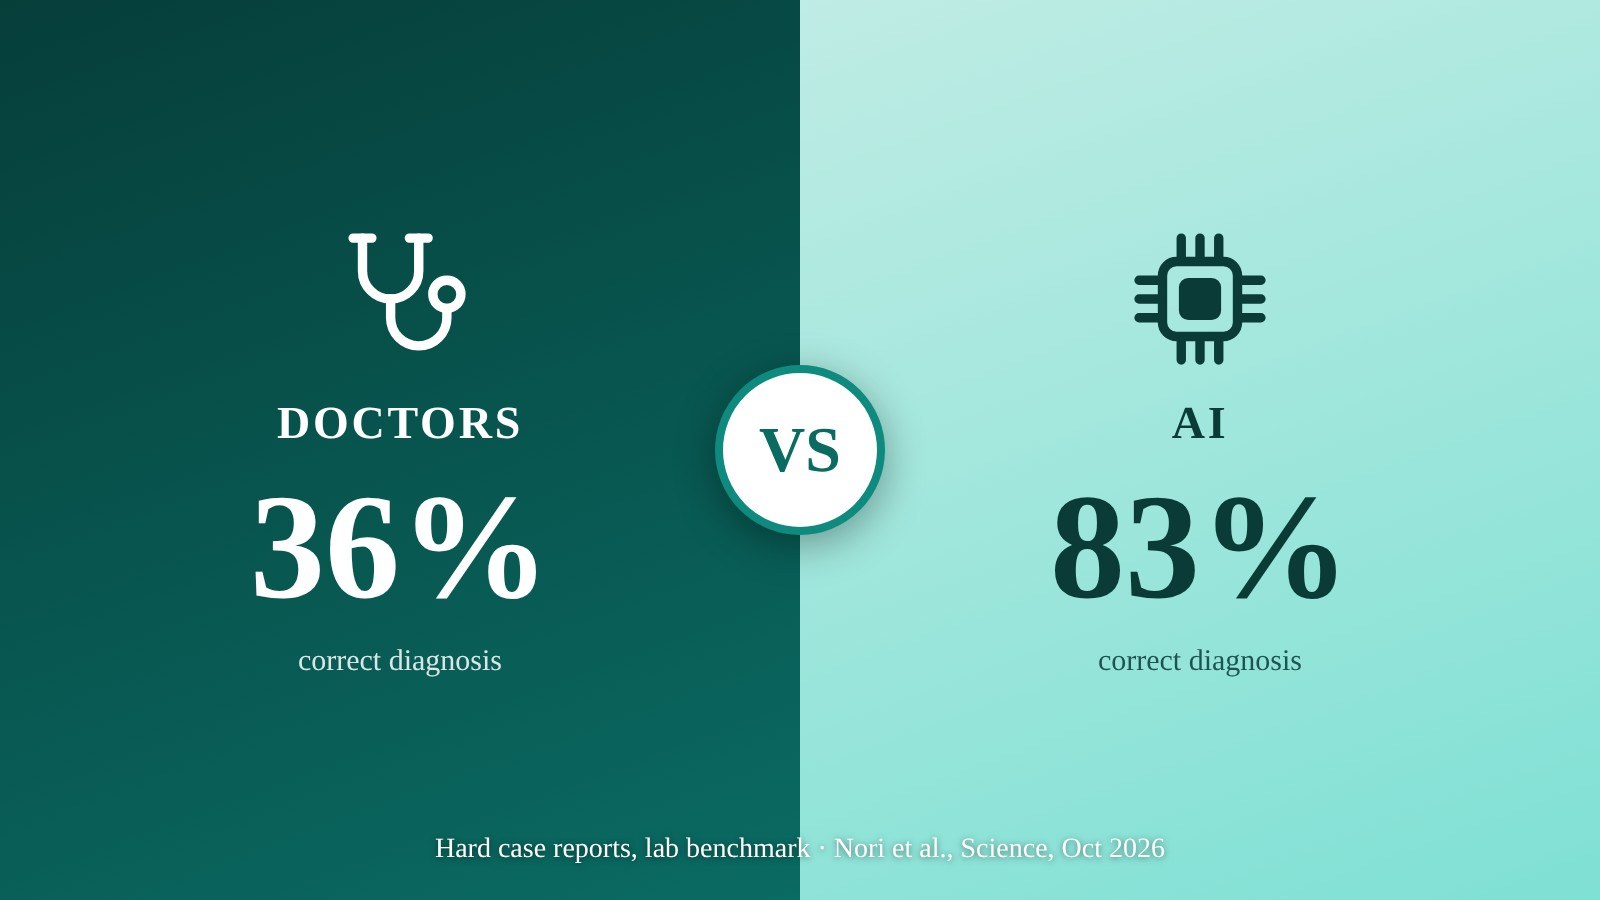
نظام مايكروسوفت الذي يعمل مثل «لجنة من الأطباء» (أكتوبر 2026). صمّم فريق من مايكروسوفت نظام ذكاء اصطناعي يتصرف كمجموعة من الأطباء: يطرح الأسئلة، ويطلب الفحوصات واحدًا تلو الآخر، ويعدّل قائمة التشخيصات المحتملة باستمرار. واختبروه على تقارير حالات معقدة من مجلة New England Journal of Medicine. وصل النظام إلى التشخيص الصحيح في 83.2% من الحالات، مقابل 36.1% للأطباء العامين. وفي حالات دخول قسم الطوارئ، حقق 80.3% مقابل 46.8% للأطباء (Nori وزملاؤه، Science، 22 أكتوبر 2026).
دراسة هارفارد ومستشفى بيث إسرائيل (أبريل 2026). قارن الباحثون نموذجًا استدلاليًا من OpenAI بمئات الأطباء في خمس تجارب، ثم أجروا اختبارًا واقعيًا على مرضى اختيروا عشوائيًا في قسم الطوارئ بمستشفى كبير في بوسطن. وفي كل التجارب، تفوق الذكاء الاصطناعي على مستوى الأطباء. وخلص الباحثون إلى أن الذكاء الاصطناعي تجاوز معظم اختبارات الاستدلال السريري، وأن هناك حاجة عاجلة الآن إلى تجارب مستقبلية حقيقية (Brodeur وزملاؤه، Science، 30 أبريل 2026).
ما أغفلته العناوين
- الأطباء في المقارنة كانوا أطباء عامين. في دراسة مايكروسوفت، قورن الذكاء الاصطناعي بأطباء الرعاية الأولية والباطنة العامة وهم يعملون منفردين. أما الأخصائيون والفرق الطبية التي تتعامل عادة مع حالات بهذا التعقيد، فلم يُختبروا.
- كان اختبارًا معياريًا لا مستشفى حقيقيًا. يقول باحثو مايكروسوفت أنفسهم إن النتائج جاءت في بيئة اختبار مضبوطة.
- نصوص فقط. قرأ الذكاء الاصطناعي ملاحظات مكتوبة عن الحالات، بينما يرى الطبيب الحقيقي مدى مرض المريض، ويسمع قصته وهي تتغير، ويفحصه بنفسه.
- دراسة هارفارد لم تقارن الذكاء الاصطناعي بأطباء الطوارئ. كان الأطباء في المقارنة من تخصص الباطنة، ولا يقول الباحثون أنفسهم إن الذكاء الاصطناعي يجب أن يحل محل الأطباء.
المفاجأة: الأطباء الذين استخدموا الذكاء الاصطناعي لم يتحسنوا كثيرًا
في عام 2024، أجريت تجربة عشوائية في عدة مؤسسات طبية أكاديمية أمريكية، وأعطي فيها 50 طبيبًا حتى ست حالات صعبة. نصفهم استطاع استخدام روبوت محادثة بالذكاء الاصطناعي، والنصف الآخر استخدم المصادر المعتادة. حصل الأطباء الذين استخدموا الذكاء الاصطناعي على 76%، والآخرون على 74%، أي بلا فرق حقيقي. لكن الذكاء الاصطناعي وحده تفوق بـ16 نقطة مئوية على الأطباء الذين لم يستخدموه (Goh وزملاؤه، JAMA Network Open، 2024).
وكرر فريق بريطاني التجربة على 22 طبيبًا في عام 2026. هذه المرة ساعد الذكاء الاصطناعي فعلًا (74.3% مقابل 65.7%). ومع ذلك، ظل الأطباء الذين استخدموه أقل بـ21.3 نقطة من الذكاء الاصطناعي وحده. والسبب كان مفاجئًا: لم يطرح الأطباء على الأداة إلا 30% فقط من أسئلة الحالات (Healy وزملاؤه، Diagnosis، 2026).
بمعنى آخر، قد لا تكون المشكلة في الذكاء الاصطناعي، بل في طريقة تعامل البشر معه: متى نثق به، ومتى نتجاهله، ومتى لا يخطر ببالنا أن نسأله أصلًا.
لماذا يهم هذا طلاب التخصصات الصحية؟
هذه الدراسات لا تثبت أن الذكاء الاصطناعي يمكن أن يحل محل الأطباء أو أخصائيي العلاج الطبيعي أو التمريض. بل تثبت أنه أصبح قويًا جدًا في مهمة واحدة محددة، هي الاستدلال من الحالات المكتوبة، وأن المهنيين الصحيين لم يتعلموا بعد كيف يستخدمونه جيدًا. وهذه الفجوة بالضبط هي المكان الذي يحتاج إلى أبحاث جديدة، والمكان الذي سيعمل فيه جيلكم.
أفكار لرسائل بحثية
- هل يستخدم الأطباء وأخصائيو العلاج الطبيعي والتمريض في مصر أو الخليج الذكاء الاصطناعي في الأسئلة السريرية، وإلى أي حد يثقون به؟ دراسة استبيانية.
- هل تغيّر جلسة تدريب قصيرة طريقة استخدام الطلاب للذكاء الاصطناعي في الحالات السريرية؟ دراسة قبلية وبعدية بسيطة أو تجربة عشوائية باستخدام حالات مكتوبة.
- ما مدى دقة الذكاء الاصطناعي في حالات العلاج الطبيعي؟ قارن إجاباته بإجابات أخصائيين خبراء على حالات مكتوبة من تخصصك.
- الثقة الزائدة والثقة الناقصة: متى يقبل الطلاب إجابة خاطئة من الذكاء الاصطناعي، ومتى يرفضون إجابة صحيحة؟
قبل تسجيل أي فكرة من هذه الأفكار، تأكد أنها لم تُدرس من قبل. يمكنك فحص فكرة رسالتك مجانًا على Neura، وستعرض لك أقرب الدراسات المنشورة.
المصادر: Nori H, et al. Sequential diagnosis with language models. Science. 2026;394:423-428. https://doi.org/10.1126/science.aeh7930 · Brodeur PG, et al. Performance of a large language model on the reasoning tasks of a physician. Science. 2026;392:524-527. https://doi.org/10.1126/science.adz4433 · Goh E, et al. Large Language Model Influence on Diagnostic Reasoning: A Randomized Clinical Trial. JAMA Netw Open. 2024;7(10):e2440969. https://doi.org/10.1001/jamanetworkopen.2024.40969 · Healy J, et al. Human-AI collaboration in clinical reasoning: a UK replication and interaction analysis. Diagnosis. 2026. https://doi.org/10.1515/dx-2025-0176